

RECHERCHE · SYSTÈMES
Un backtesteur walk-forward reproductible
Parité interlangage, segmentation des régimes et tests de robustesse pour la recherche systématique.
Un backtesteur de niveau recherche implémenté en Python et Rust. La parité interlangage détecte les écarts entre implémentations, tandis que les contrôles couvrent le walk-forward, les coûts réalistes et la robustesse. Le code est open source sous Apache 2.0. Les exemples inclus fonctionnent sans téléchargement ; le benchmark de 150 000 bougies possède une recette de données reproductible distincte.
Document de travail SSRN
En évaluation, pas encore publié.
Code source sur GitHub
github.com/DaruFinance/quant-research-framework-rs
En bref
Exécution walk-forward complète
7,20 s Rust · 112,37 s Python
Un lot de 150 000 bougies couvre 10 configurations fixes et 28 fenêtres walk-forward. Rust a été 15,61× plus rapide dans cette observation, avec des registres Rust identiques avant et après le correctif d'écriture tampon.
Exécution appariée
4 moteurs · 20 137 trades chacun
Un test distinct à événements figés compare QRF Rust, QRF Python, Backtesting.py et vectorbt sur les mêmes ordres long-only. Chronologie et prix concordent, avec un P&L normalisé à 7,28e-12 près.
Parité
Les différences deviennent des échecs de test
Comparer leurs sorties peut révéler des erreurs de portage, mais ne prouve pas un edge et n'élimine pas les erreurs communes.
De quoi s'agit-il ?
La plupart des backtesteurs open source fournissent une boucle d'exécution et laissent la discipline de recherche à l'utilisateur : séparation entre apprentissage et hors échantillon, indicateurs pouvant voir le futur, effets des frais, du slippage et du funding. Ce framework intègre ces contrôles avec l'optimisation walk-forward, la segmentation par régime, des paramètres de réalisme et cinq scénarios de robustesse. Un invariant du registre de trades interdit de négocier une bougie non clôturée.
La même spécification est implémentée en Python et en Rust, puis comparée point par point. Cette couche de parité détecte les écarts entre implémentations ; elle n'établit pas un edge rentable et ne protège pas contre une erreur partagée. Les figures distinguent les sorties historiques de recherche des mesures de performance de septembre 2026.
Comment les éléments s'articulent
Les données passent par un noyau d'indicateurs commun vers un contrat de stratégie qui renvoie un signal par bougie. Le noyau d'exécution applique les coûts, puis l'orchestrateur walk-forward ré-optimise et teste chaque fenêtre. Enfin, le harnais de parité compare les registres de métriques des deux implémentations.
Walk-forward par construction
Chaque itération optimise sur une fenêtre glissante in-sample, teste la sous-fenêtre out-of-sample suivante, puis avance. Aucune fenêtre n'est notée sur les observations utilisées pour l'ajuster.
Ce que produit une exécution
L'exemple historique de cette section emploie la stratégie EMA-crossover incluse sur SOL/USDT 1h. Il produit des rapports optimisés in-sample et out-of-sample, cinq scénarios de robustesse et 18 fenêtres walk-forward glissantes. Ces figures appartiennent à cet exemple, non aux tests de performance ultérieurs sur 150 000 bougies.
L'exemple perd de l'argent, ce qui rend les contrôles plus faciles à examiner : chaque sortie montre où une stratégie faible échoue plutôt que de devenir une recommandation de trading.
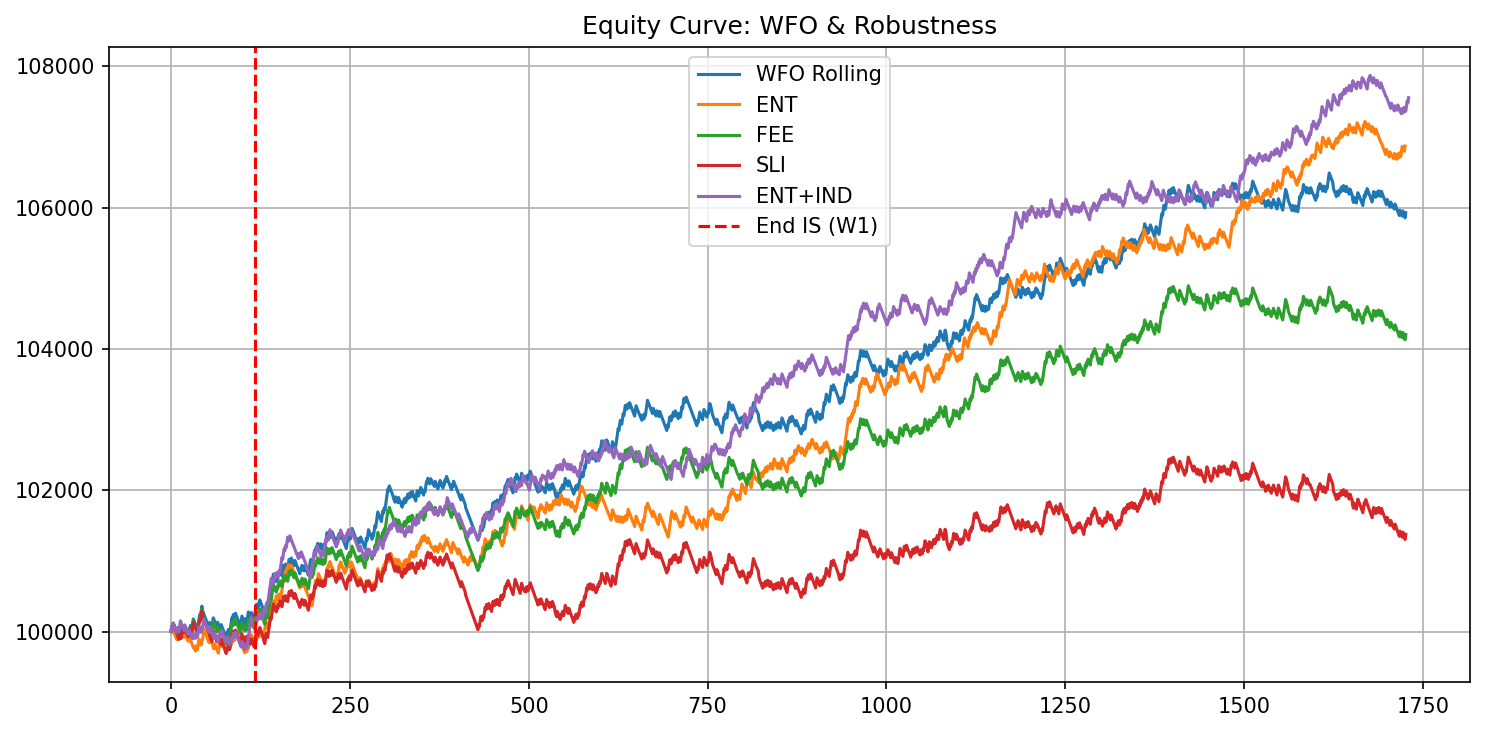
Dans cet exemple historique, la courbe walk-forward assemblée a monté. La procédure ne garantit pas ce résultat : chaque fenêtre in-sample choisit un nouveau lookback avant le test suivant, d'où la nécessité des contrôles agrégés et de déflation.
Les métriques produites
Dans cet exemple, le Sharpe optimisé hors échantillon vaut -2,91 après coûts.
  IS-opt  (LB 47) | Trades: 118   ROI: $-735.77     PF: 0.61   Sharpe: -2.69   MaxDD: $804.82
 OOS-opt  (LB 47) | Trades: 755   ROI: $-2,077.85   PF: 0.81   Sharpe: -2.91   MaxDD: $2,258.93
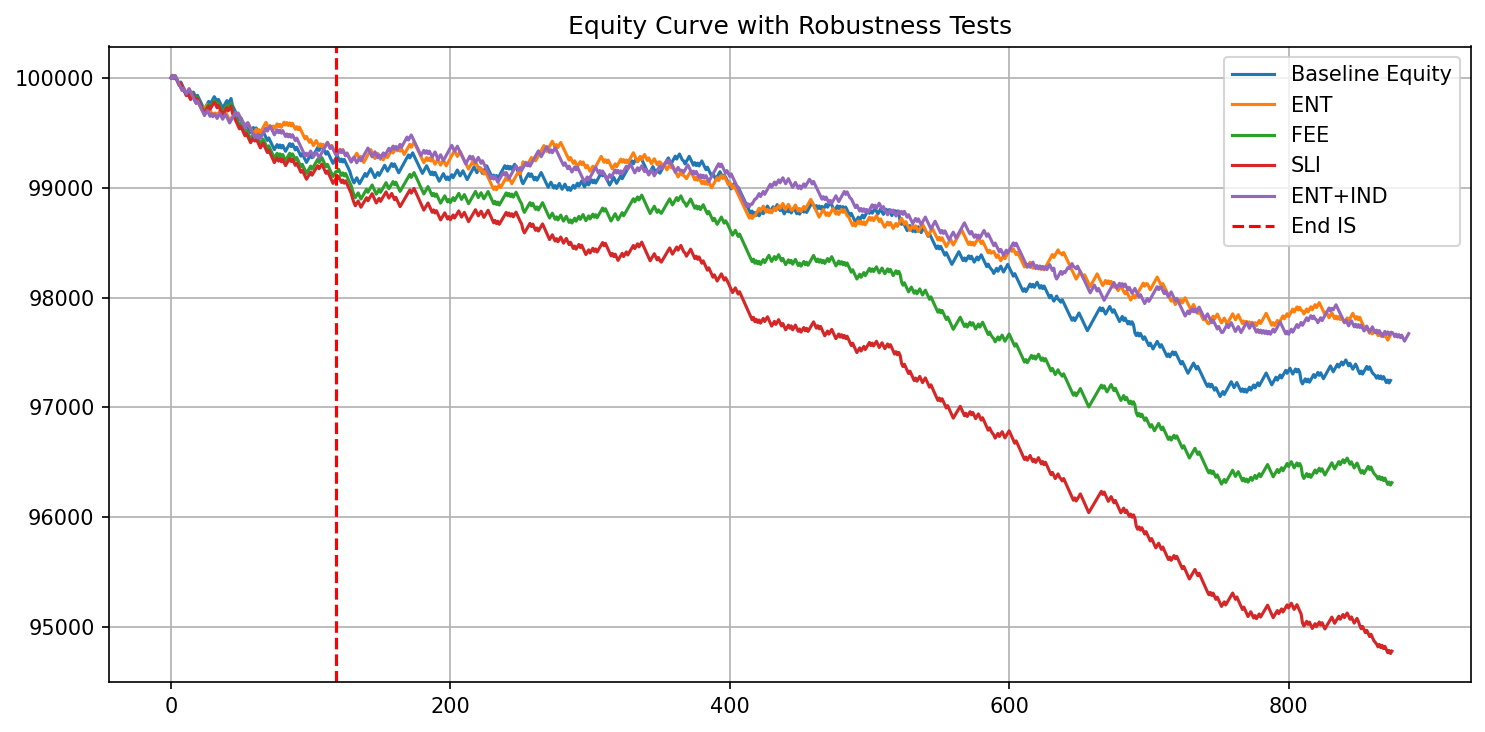
Le balayage de robustesse réexécute la base optimisée sous quatre perturbations. Le choc de slippage est le pire cas ; un retard d'entrée d'une bougie change moins. Leur écart consigne la sensibilité aux hypothèses hors du contrôle de la stratégie.
 Baseline OOS | ROI: $-2,077.85   PF: 0.81   Sharpe: -2.91   MaxDD: $2,258.93
     ENT OOS | ROI: $-1,623.33   PF: 0.84   Sharpe: -2.30   MaxDD: $1,809.32   entry drift +1 bar
     FEE OOS | ROI: $-2,832.73   PF: 0.74   Sharpe: -3.99   MaxDD: $2,876.37   fees x2
     SLI OOS | ROI: $-4,303.79   PF: 0.64   Sharpe: -6.11   MaxDD: $4,346.15   slippage shock
 ENT+IND OOS | ROI: $-1,629.68   PF: 0.85   Sharpe: -2.29   MaxDD: $1,875.23   drift + indicator jitter
Le rapport glissant montre chaque fenêtre séparément. W01 gagne 899,57 $ hors échantillon, mais les fenêtres ultérieures et le résultat agrégé déterminent si la stratégie survit à l'évaluation.
 Running Walk-Forward Windows
  W01 IS  (LB 47) | Trades: 118   ROI: $308.25   PF: 1.14   Sharpe:  0.63   MaxDD: $448.35
 W01 OOS  (LB 47) | Trades:  92   ROI: $899.57   PF: 1.57   Sharpe:  1.95   MaxDD: $243.77
  ...   W02 through W18 each re-optimise on the rolling in-sample window
        and forward-test the next window on data they never saw   ...
Trois modes Monte Carlo
La file rend explicite la règle d'échantillonnage. La permutation des trades réordonne les rendements réalisés sans remise. Le rééchantillonnage des trades les tire avec remise. La permutation des barres reconstruit des trajectoires OHLCV, puis régénère les signaux et réexécute une stratégie et un jeu de paramètres figés sur chaque trajectoire. Chaque mode sélectionné produit son propre résultat, et le mode barres n'est pas déclenché par l'API ordinaire des rendements de trades.
Entrée
01Rendements de trades terminés
Règle d'échantillonnage
02Mélange sans remise. Chaque trade réalisé apparaît exactement une fois.
Évaluation
03Recalcule les métriques dépendantes du chemin à partir du chemin de trades réordonné ; ne réexécute pas la stratégie.
Sortie enregistrée
04Résumé Monte Carlo au niveau des trades pour la graine et le nombre d'exécutions demandés.
La permutation des barres est coûteuse : sa valeur par défaut de 500 exécutions implique des centaines de backtests complets. La stratégie EMA incluse utilise le worker Rust du dépôt dans les deux packages ; une stratégie Python personnalisée emprunte le chemin explicite du callback Python.
Consistency est l'exemple de score d'optimisation personnalisé de Daniel Gatto, et non une métrique financière standard. Les utilisateurs peuvent remplacer dans le code son calcul et la recherche de son objectif par leur propre score.
Performance, mesurée de deux façons
Le premier panneau mesure un lot walk-forward complet sur 150 000 bougies BTCUSDT spot réelles en 30 minutes : 5 familles de stratégies, chacune avec 2 lookbacks fixes, sur 28 fenêtres hors échantillon. Le second isole un contrat d'exécution commun sur 4 moteurs avec événements d'ordre figés. Ils répondent à des questions différentes et leurs ratios ne sont pas interchangeables. Méthode du benchmark, résultats bruts et recette de données.
Parité interlangage
Le relevé historique de parité ci-dessous couvre 210 points de métriques du noyau déterministe sur 3 surfaces de configuration. Il est distinct des nouveaux benchmarks à 10 configurations : leurs métriques walk-forward complètes différaient au plus de 6,66e-14 et leurs registres d'exécution appariée concordaient sur chronologie, sens, prix et quantité normalisée.
Comparaison
Chaque capacité existe dans d'autres backtesteurs. Ce projet les combine et rend les contrôles de recherche applicables plutôt que de simples conventions facultatives.
Toutes les fonctionnalités
Le PBO et le DSR ouvrent la liste, car ils évaluent si un résultat optimisé mérite une analyse plus poussée. Les libellés ci-dessous distinguent le pipeline principal, les rapports optionnels, les API autonomes et les modules facultatifs.
Clonez et examinez les exemples inclus
Les commandes ci-dessous utilisent les données d'exemple du dépôt, sans clé API ni téléchargement. Le benchmark de 150 000 bougies est distinct et utilise la recette de données reproductible liée dans sa documentation.
Les stratégies incluses démontrent le pipeline plutôt qu'elles ne revendiquent un edge négociable. Les pertes hors échantillon après coûts montrent que le moteur expose une stratégie faible au lieu de la masquer.
Citation
L'article associé est en évaluation chez SSRN. Jusqu'à sa publication, citez le framework depuis son dépôt.
Voir aussi
Lire le test de permutation au sein d'une stratégie pour la méthode de sélection que ce backtesteur prend en charge, puis consulter la Research Review pour des reproductions indépendantes fondées sur le walk-forward et une évaluation consciente de la déflation.